Auto下线后WorkBuddy三档模型怎么选最省钱?- 企动云
摘要:WorkBuddy 将 Auto 模式换成「快速 / 均衡 / 极致」三档模型,思考强度也变成可理解的设置。本文站在用户和代理商视角,讲清三档差在哪、什么任务选哪档最省钱、哪些设置会偷偷吃积分(上下文窗口、Max 模式、思考强度),以及企业怎么选型、接自定义模型要不要额外花钱、企动云帮您详解分析,看完可照着选。
一、这次更新了什么
一句话:WorkBuddy 把原来的 Auto 模式换成了「快速 / 均衡 / 极致」三档模型,思考强度也从后台自动变成了你能理解的设置。
不少老用户发现,对话界面里的 Auto 不见了,取而代之是三档手动选择。这不是换个名字,而是把"用哪个模型、花多少"的决定权交还给你。企业版更新即生效,不用单独开通,也不用加钱。
二、和原来的 Auto 比,到底变了什么
Auto 时代:系统后台自己挑模型,你只管打字,不知道用的是谁、跑了多少消耗,复杂任务有时被"将就"成普通档。
三档时代:你按任务主动选,结果和消耗都可预期。
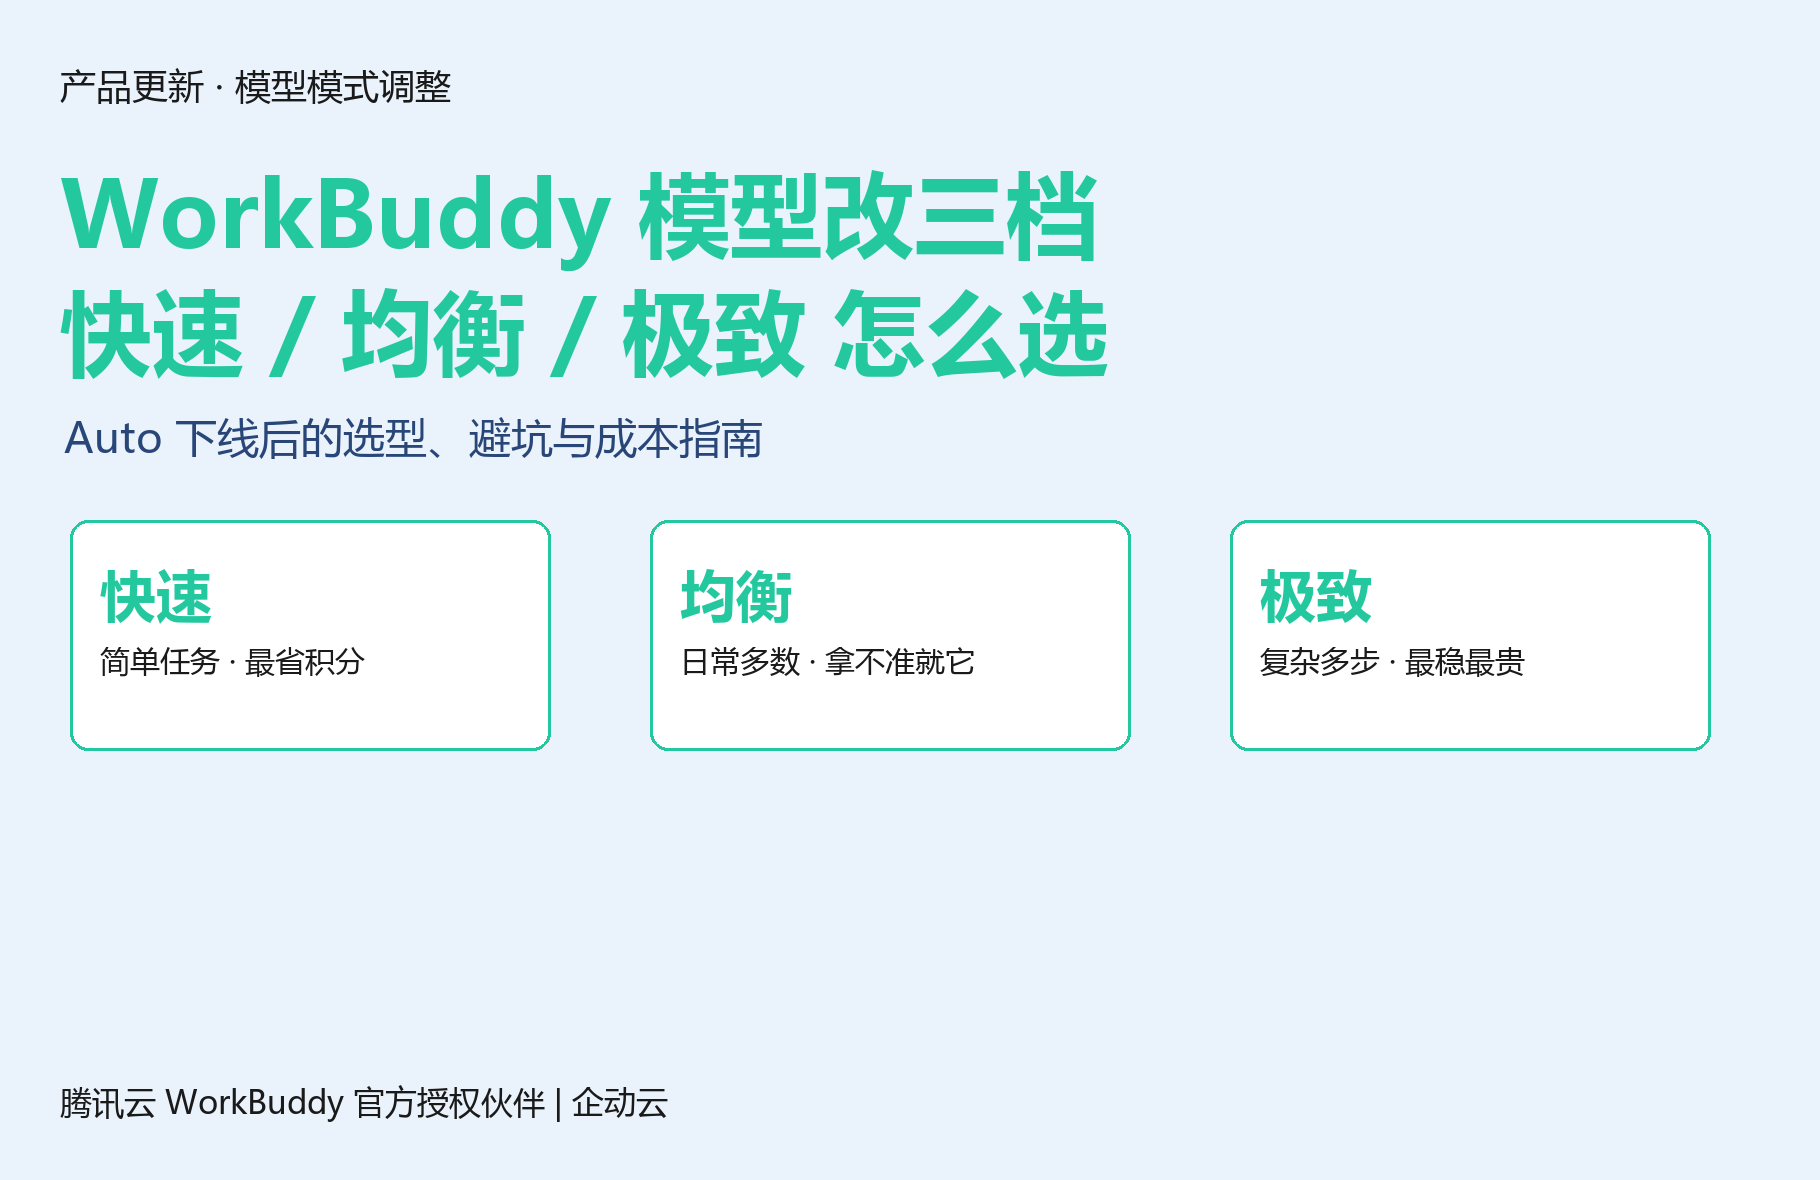
- 快速:任务简单明确(日常问答、格式转换、小改代码、文案润色),响应最快、最省积分。
- 均衡:绝大多数日常工作(写文档、分析数据、多文件改动),效果和速度兼顾,拿不准就选它。
- 极致:复杂、多步骤、要反复验证(跨模块重构、长链推理),最稳但消耗最高。
思考强度不是第四档,是模型作答前的推理投入:强度高就多分析、多自查,适合容易出错的长逻辑任务;强度低就直接答、响应快。系统已默认选了适合多数任务的档位,一般不用动。
三、对你有什么用:落地和成本角度的三条实话
1. 选型:别一上来就开极致
日常写周报、回邮件、做表,均衡就够了;赶时间的小改动用快速;只有跨模块重构、要逐条复核的分析才上极致。需要把 WorkBuddy 接进企业微信自动发消息、查文档的,也建议默认均衡(参见 WorkBuddy 接企业微信的 8 个用法)。
2. 避坑:三个会偷偷吃掉积分的设置
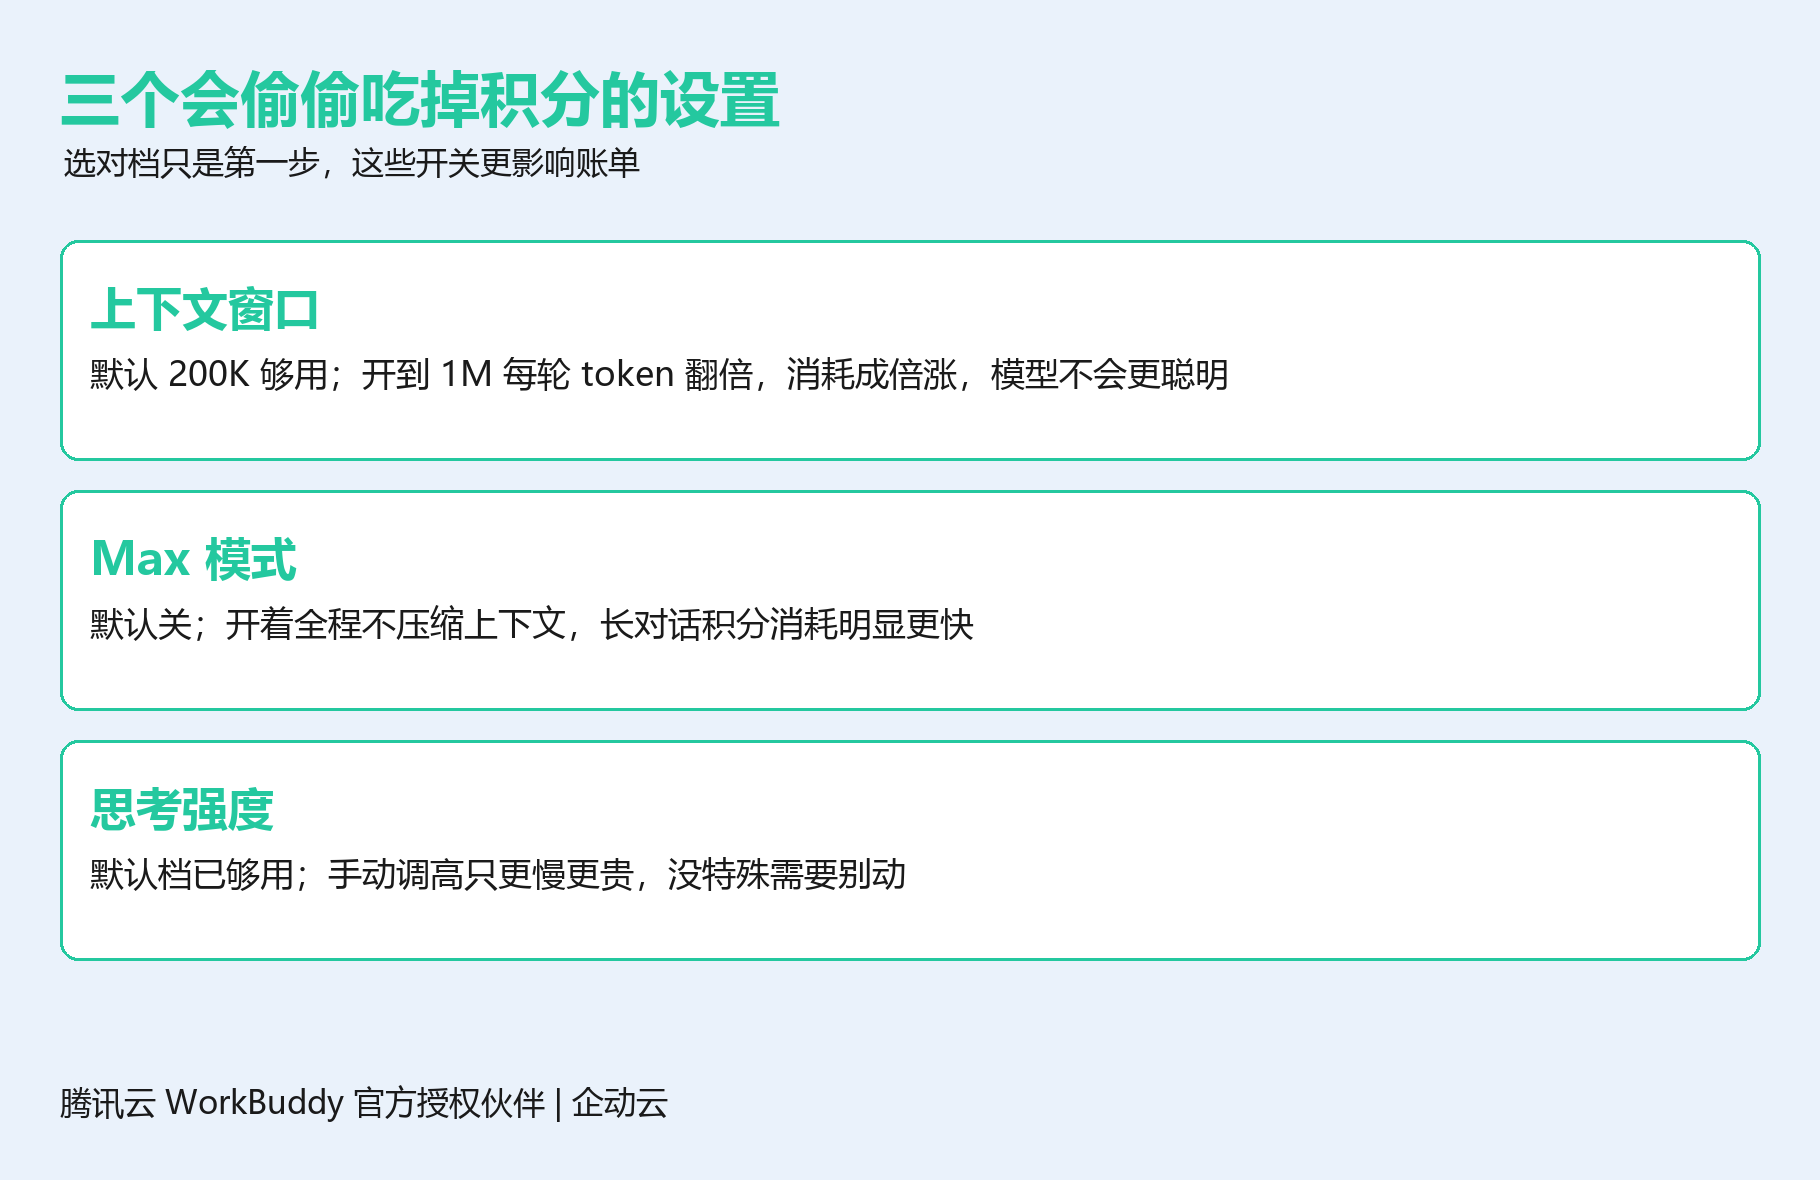
上下文窗口:默认 200K 够绝大多数任务。开到 1M 不会让模型变聪明,只会让每一轮对话的 token 翻倍,消耗成倍涨。
Max 模式:默认关。开着会全程保留上下文不做压缩,长对话的积分消耗明显更快。
思考强度:默认档已经够用,手动调高只会更慢更贵,没特殊需要别动。
WorkBuddy 上下文窗口开太大为什么更费积分?
每一轮对话都会把当前上下文完整发给模型。窗口越大,单轮 token 越多,消耗越多。200K 已是兼顾值,只有处理超长文档或要完整记住大量历史时才调大,否则纯属浪费。
3. 价格:三档消耗不同,自定义模型另算
三档本身消耗不同——快速最低、极致最高,这是选型的隐性成本。
内置的 14 个模型(Hy3、Hy4 preview、GLM 全系、MiniMax、Kimi、DeepSeek 等)走 WorkBuddy 套餐额度。如果你要接自己的模型:
- 自定义模型:费用你直接向第三方付,WorkBuddy 只做通信通道,不赚差价也不读内容。
- Token Plan:腾讯云推出的套餐,兼容混元、MiniMax、Kimi、GLM,个人和企业都能买。
- 本地部署:用 Ollama 一行命令拉开源模型,数据不出本机、零 API 成本,适合金融、政企这类敏感场景。
企业版采购与计费细节,可看 WorkBuddy 企业版价格与采购指南。
腾讯云 WorkBuddy 自定义模型怎么接入第三方大模型?
在设置-模型里用图形界面配置,从供应商列表选(或填自定义 API),URL 和能力标记自动补全,只补 API Key 就能用,不用碰配置文件。本地 Ollama 启动后默认监听 11434 端口,WorkBuddy 直接对接。
四、怎么升级 / 开通
三档模型企业版内置,客户端更新后即生效,无需申请。自定义模型在设置页-模型可视化增删改;本地 Ollama 一行命令。需要把选型、权限、培训一次性落地的,企动云可协助做企业版部署与场景梳理。
五、注意事项 / 已知限制
- 三档消耗不同,极致档跑复杂任务会更快用掉套餐额度,团队要有人看账单。
- 自定义模型费用由第三方收,留意对方账单,别超预算。
- API Key 只存在本地 models.json,别在共享环境填写或外泄。
- 混合模型下,多模态任务(看图、出图)是否会切模型扣费,以实际界面提示为准。
常见问题
WorkBuddy 快速、均衡、极致三档该选哪个?
结论:拿不准就选均衡。日常简单任务用快速省积分;写文档、分析数据用均衡;只有多步骤、要反复验证的复杂任务才上极致。别因为"极致听起来更强"就常开,它最费额度。
思考强度是什么,要不要手动调高?
结论:一般不用调。思考强度是模型作答前的推理投入,不是独立模型。系统默认档适合绝大多数任务;只有逻辑链长、容易出错的任务才值得调高,代价是更慢更贵。
WorkBuddy 上下文窗口开到 1M 会更聪明吗?
结论:不会,只会更费钱。每轮对话都把完整上下文发给模型,窗口越大 token 越多。默认 200K 够用,只有超长文档或要完整记大量历史才调大。
Max 模式开着有什么影响,要不要开?
结论:默认关,别开。开着会全程保留上下文不做压缩,长对话积分消耗明显更快。只有需要超长上下文、细节一点不丢时才开。
自定义模型要不要额外花钱,怎么接?
结论:要,直接向第三方付。WorkBuddy 只做通道,费用归模型方。在设置-模型用图形界面填 API Key 即可;金融、政企看重合规的,可用 Ollama 本地部署,数据不出机、零 API 成本。企动云也能协助做私有化与本地模型对接方案。
企业多人用,模型档位和费用怎么管?
结论:档位每人自己选,费用看套餐额度。建议给团队定个默认(日常均衡、紧急快速),把极致留给真复杂任务;自定义模型统一由管理员配,避免每人乱接第三方产生散账单。采购与席位计费见企业版价格指南,企动云可提供选型与实施陪跑。
腾讯云 WorkBuddy 官方授权伙伴 | 腾讯企业产品服务 | 企动云 - 13918363542(微信同号)
AI摘要
WorkBuddy将Auto模式改为快速、均衡、极致三档模型,思考强度从后台自动变为用户可调。快速适合日常问答与格式转换,均衡适合写文档与数据分析,极致适合跨模块重构与长链推理。三个容易多耗积分的设置:上下文窗口开至1M、Max模式常开、思考强度手动调高。自定义模型费用由第三方直接收取,WorkBuddy只做通信通道;本地部署可用Ollama,数据不出机、零API成本。企动云为WorkBuddy官方授权伙伴。
关键词:WorkBuddy模型, WorkBuddy三档, 快速均衡极致, WorkBuddy积分, 自定义模型, 腾讯云, 企动云